分かったこと
(良い点)
・token消費(コンテキスト消費)が激的に少ない
・なんでこんなにファンネルtokenが持つんだ!?
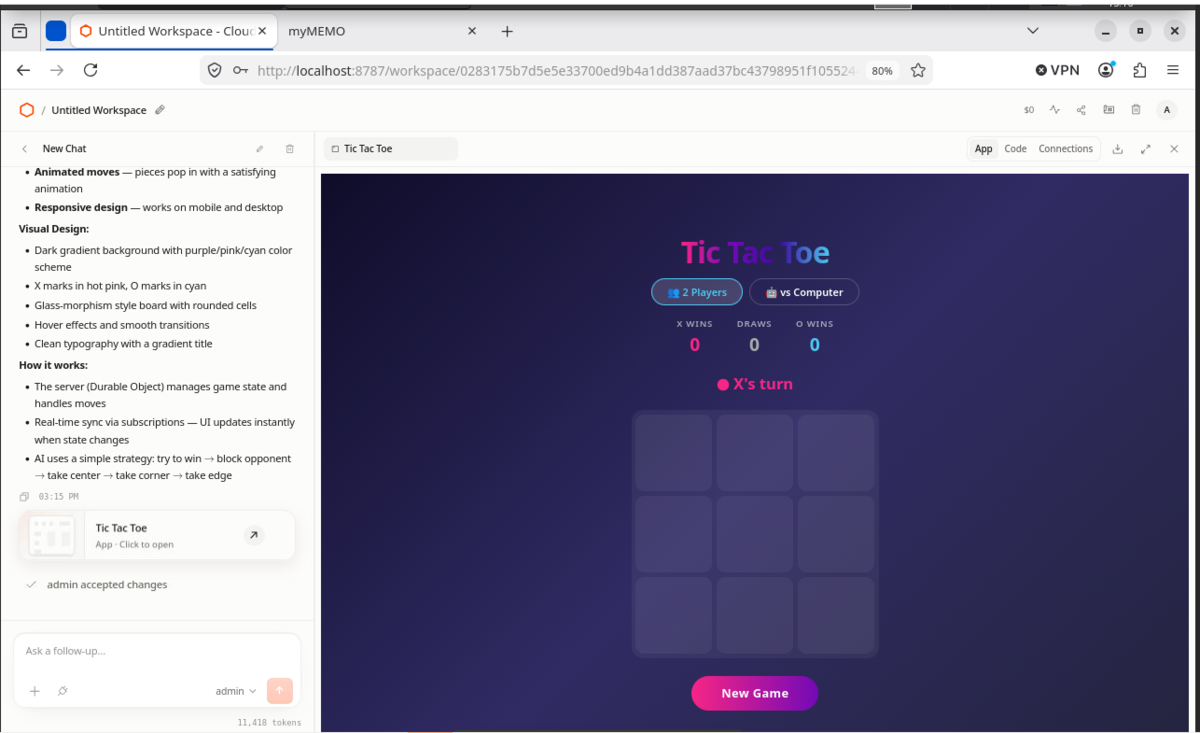
・大きめのアプリ作成タスクでも完遂できる
・ローカルLLM(OpenWebUI+Qwen3.6 35B A3B)より遥かに効率的
・ローカルLLMだとすぐにtoken上限に達して止まってしまうような重いタスクを依頼してもエージェントが止まらずに完走してくれる
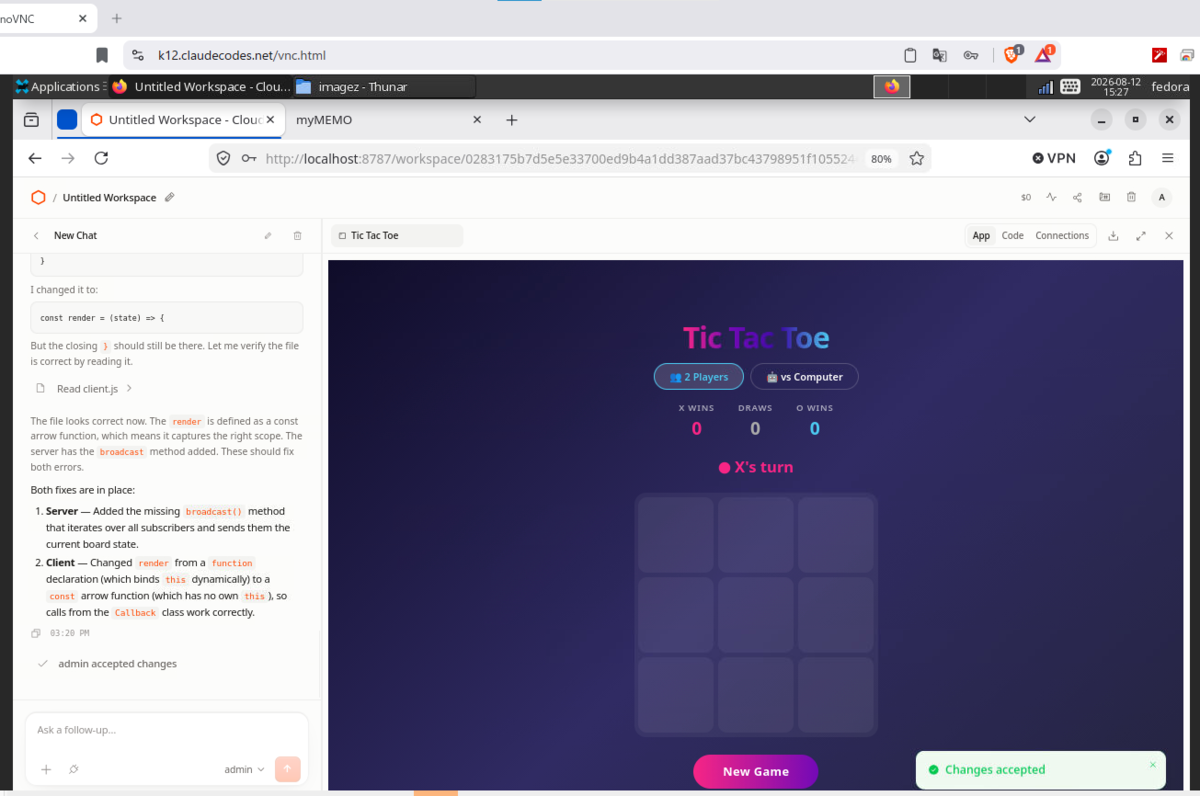
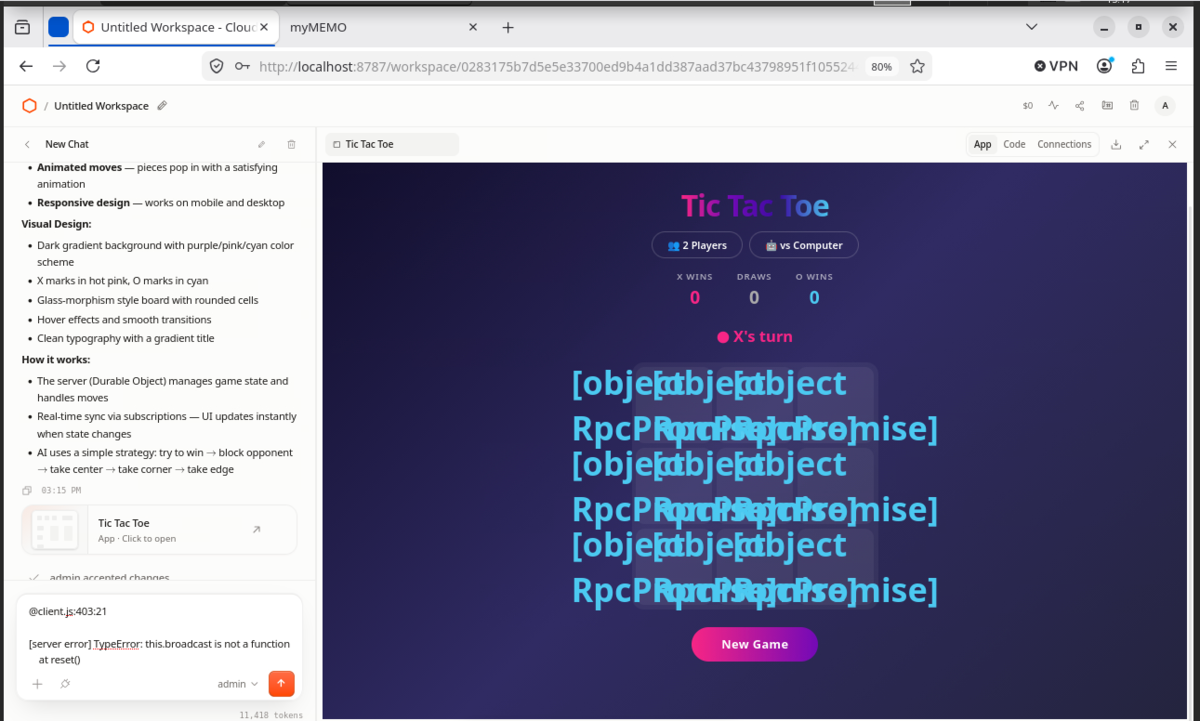
・それでもtokenが溢れて止まることがあるけど、その時も前のChatで依頼した作業の続きをさせることができるっぽい。
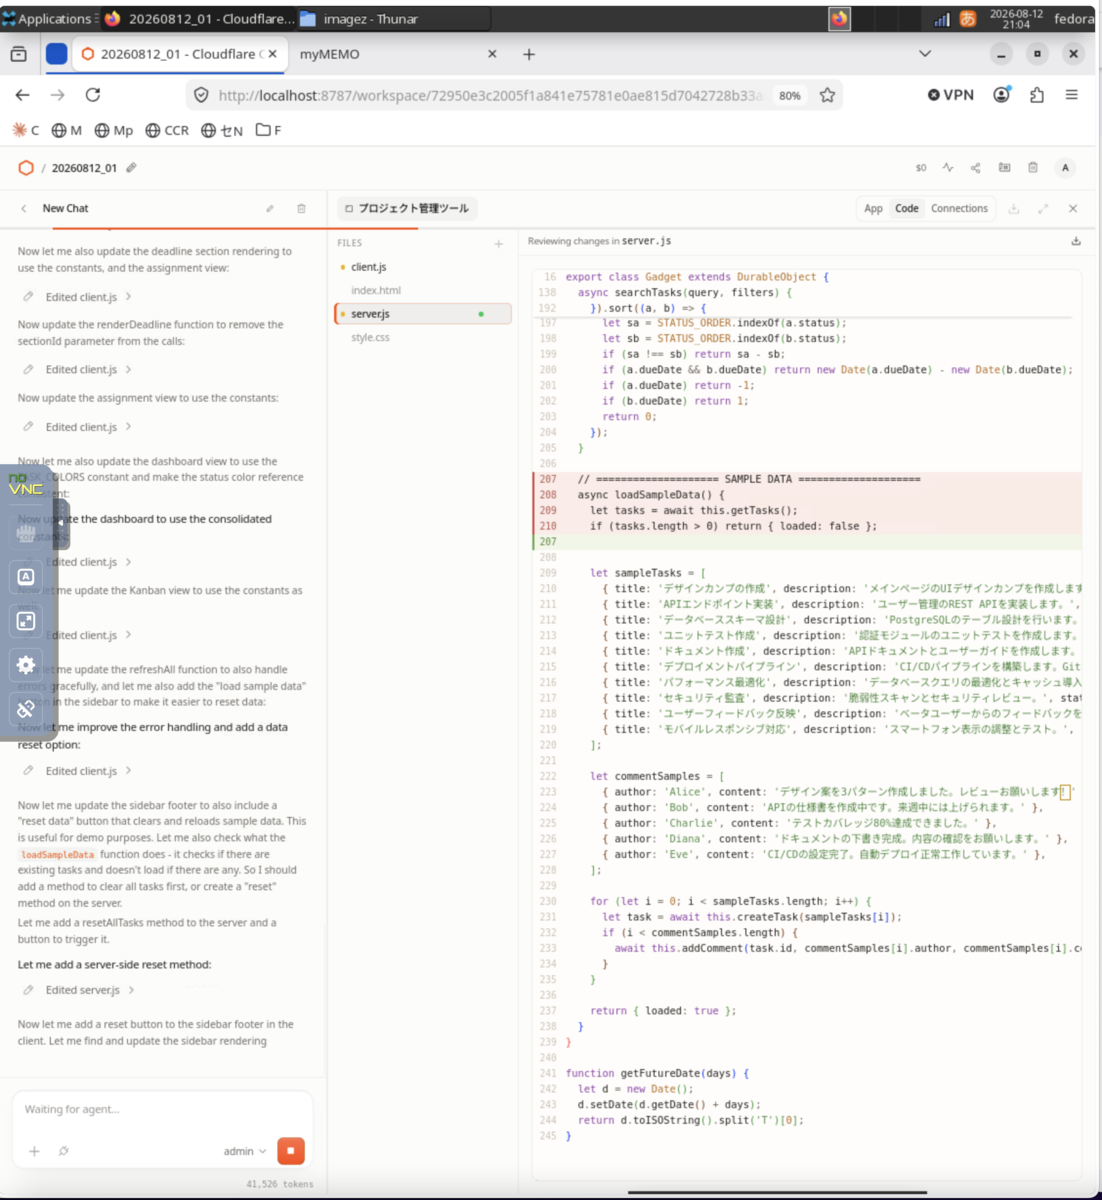
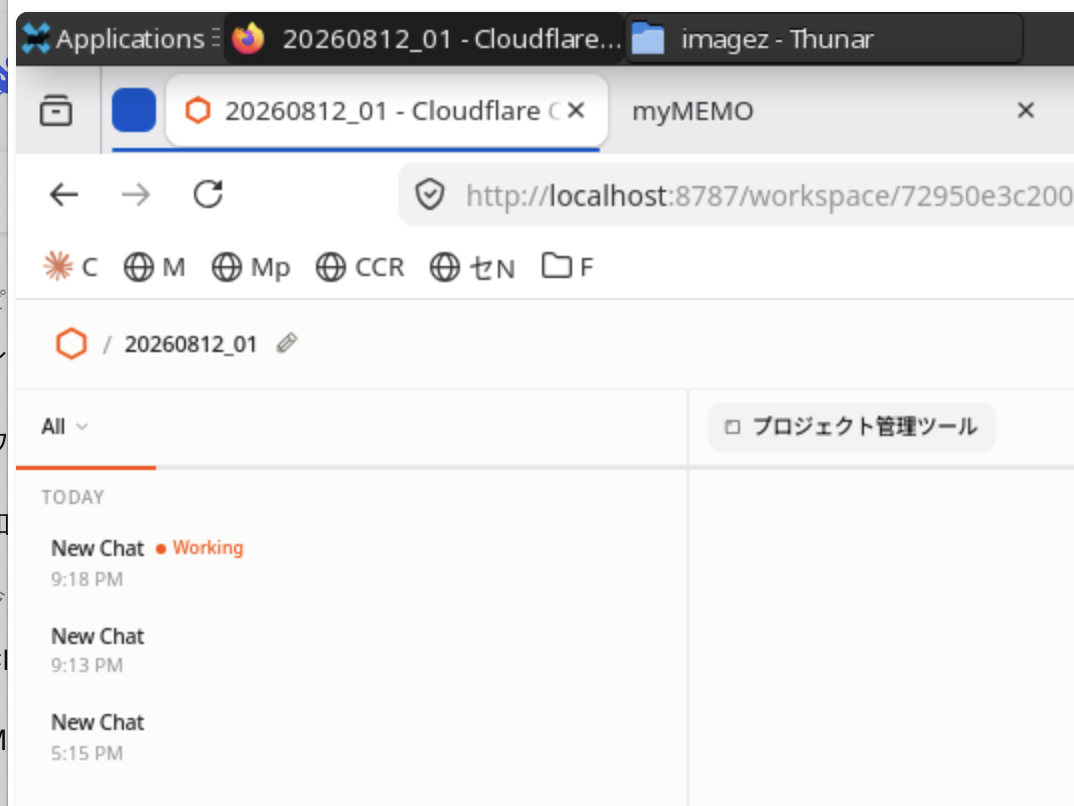
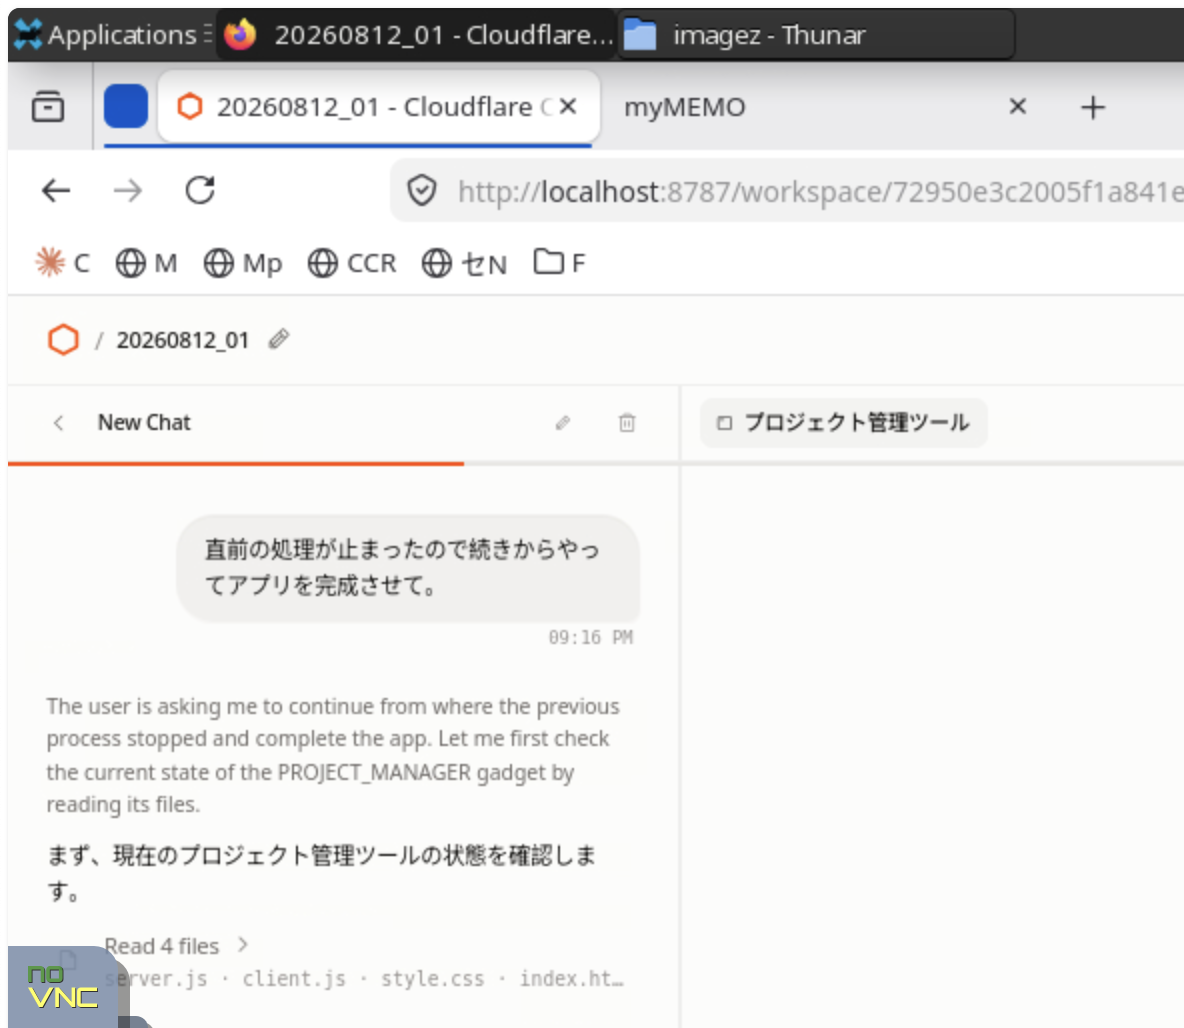
(使い方とか)
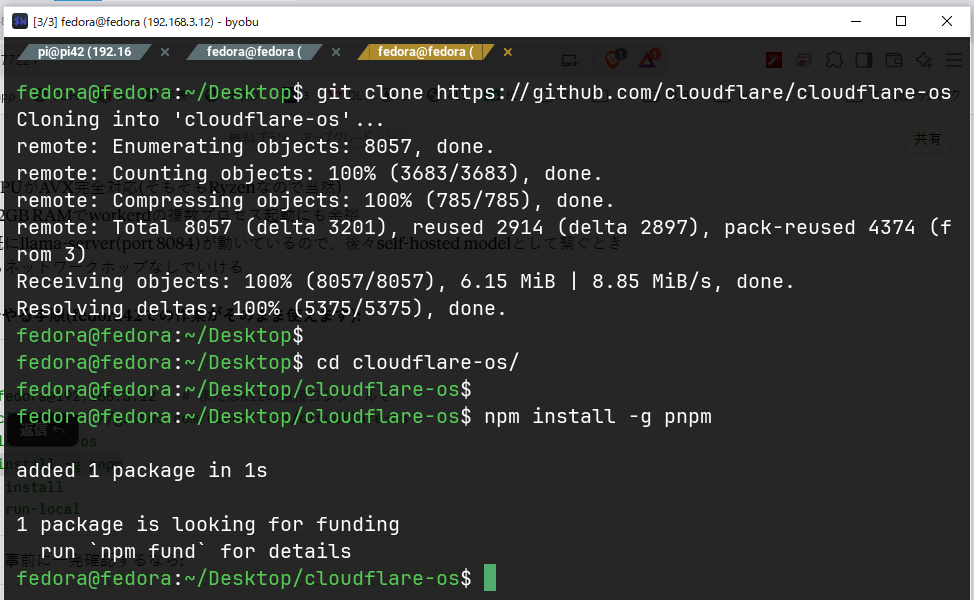
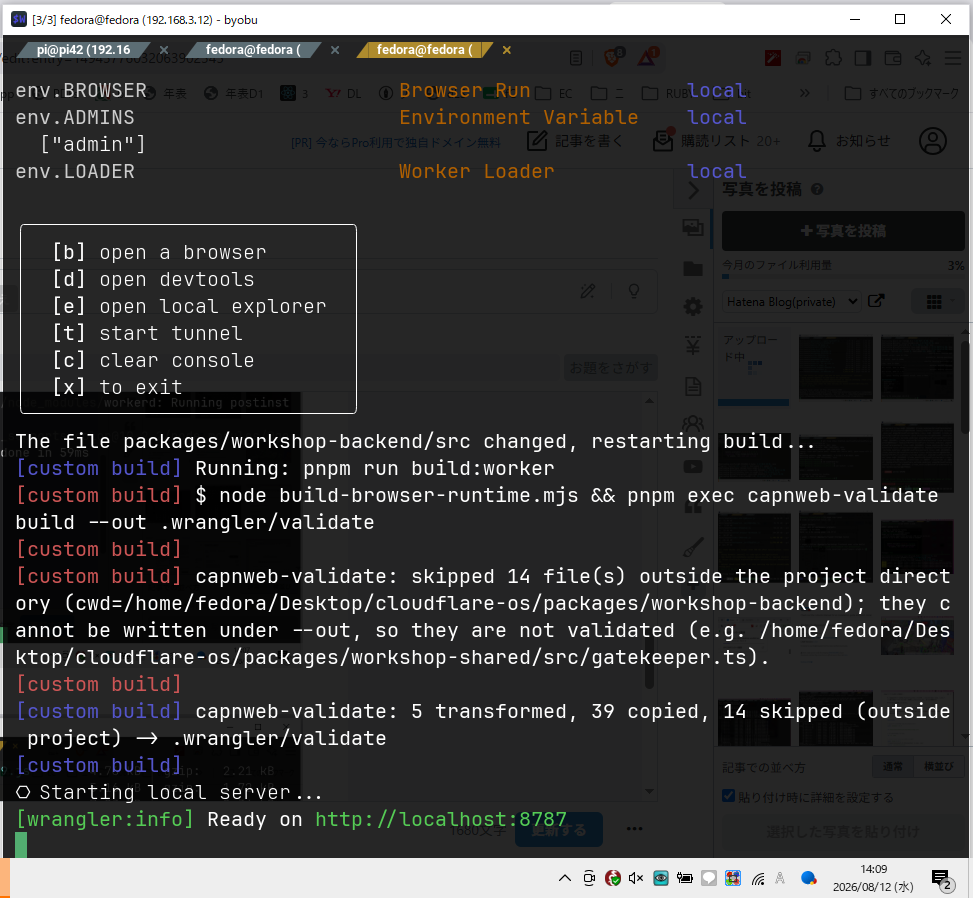
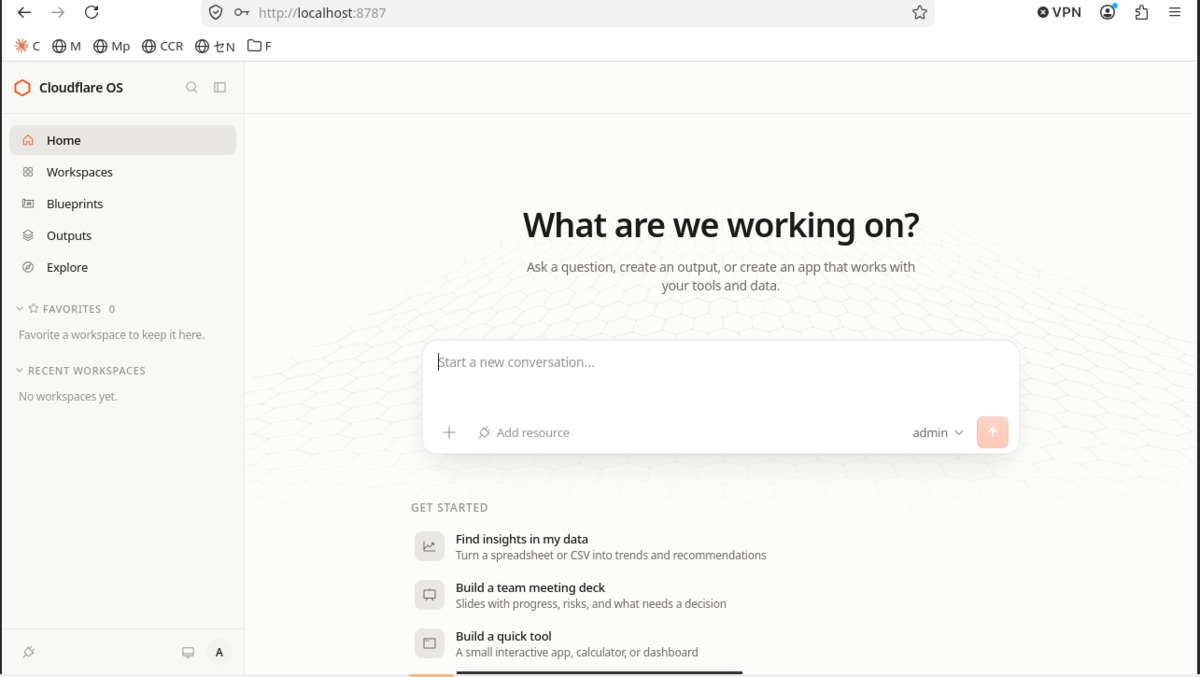
・AIサーバーにCloudflareOSをインストール → VNC経由でAIサーバに入る → ブラウザから http://localhost:8787 で起動したら(チャットから)作業を丸投げしておくだけ
・OpenClawだとサーバ基盤環境ごとぶっ壊される可能性あるけど、その心配がない(CloudflareOSではゲートキーパーがしっかり本番環境を保護してくれる)